
StackFlow AI Platform
模型库
开发示例
StackFlow AI Platform
StackFlow 是运行在边缘计算设备上的本地 AI 服务平台。它通过软件包提供大语言模型、多模态、计算机视觉、语音识别和语音合成等能力,并提供统一的服务调用方式。
使用流程
- 准备设备:完成硬件连接、网络配置以及必要的系统或驱动安装,确保设备可以正常运行并能够访问终端。
- 安装或更新 StackFlow:按照设备教程配置对应的软件源,安装或更新 StackFlow 基础软件包。部分设备出厂时已经预装,只需按需更新。
- 选择并安装 AI 能力:根据应用需求选择模型类型,然后安装相应的功能服务和与设备平台匹配的模型包。
- 运行与调用:参考模型文档和开发示例启动服务,再选择合适的接口将本地 AI 能力集成到自己的应用中。
安装 StackFlow
不同设备的系统环境和计算平台有所区别,对应的软件源、安装命令和预装状态也可能不同。请从下方选择所使用的设备,进入相应的安装或更新教程。
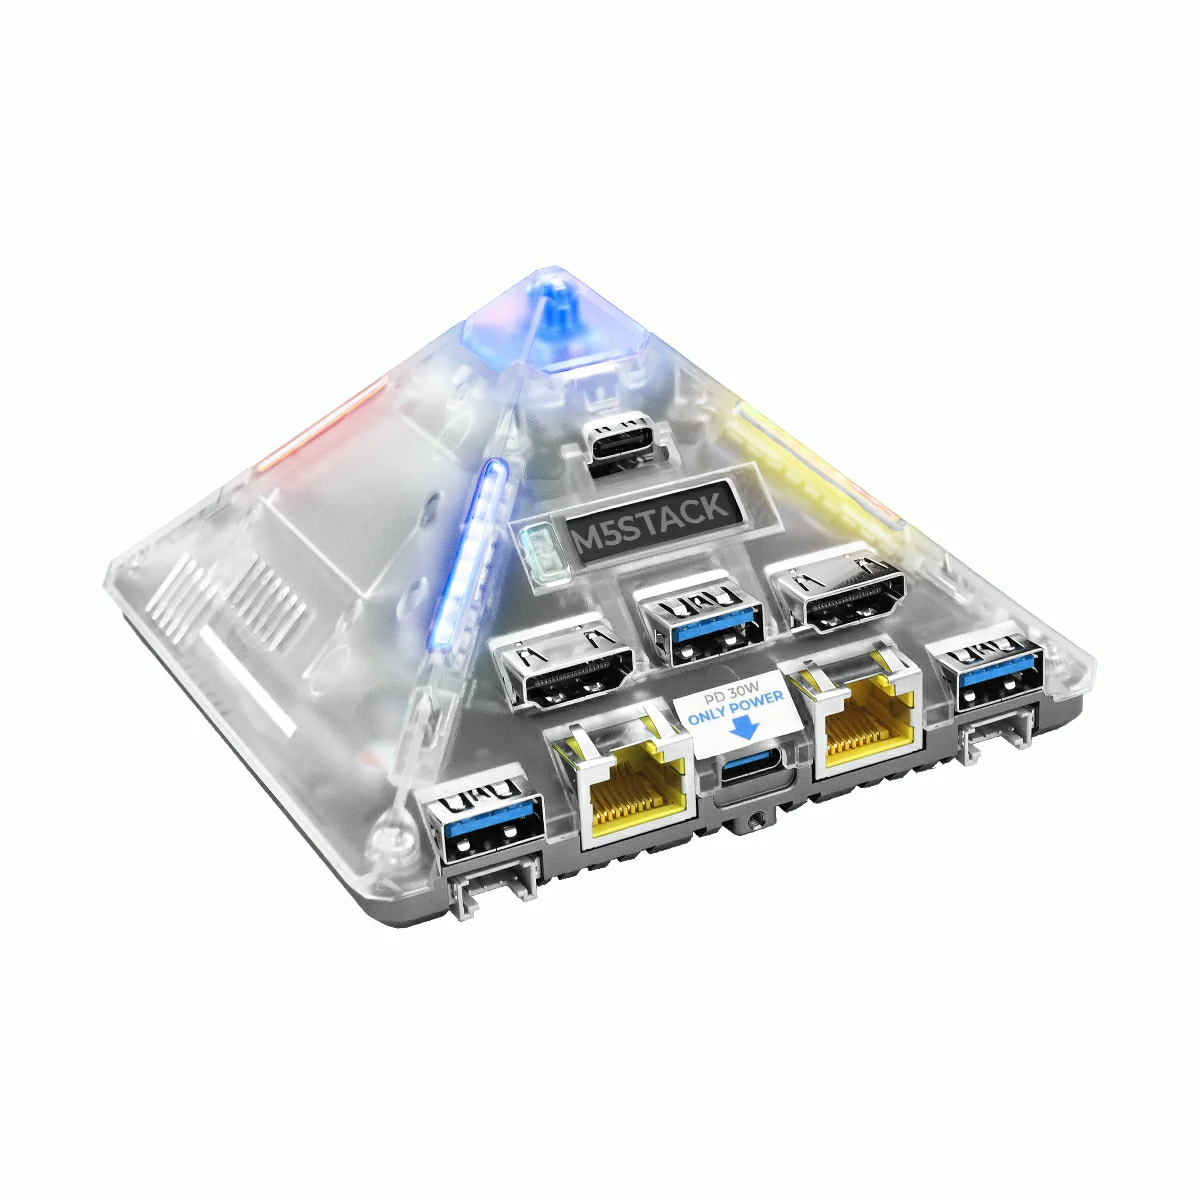

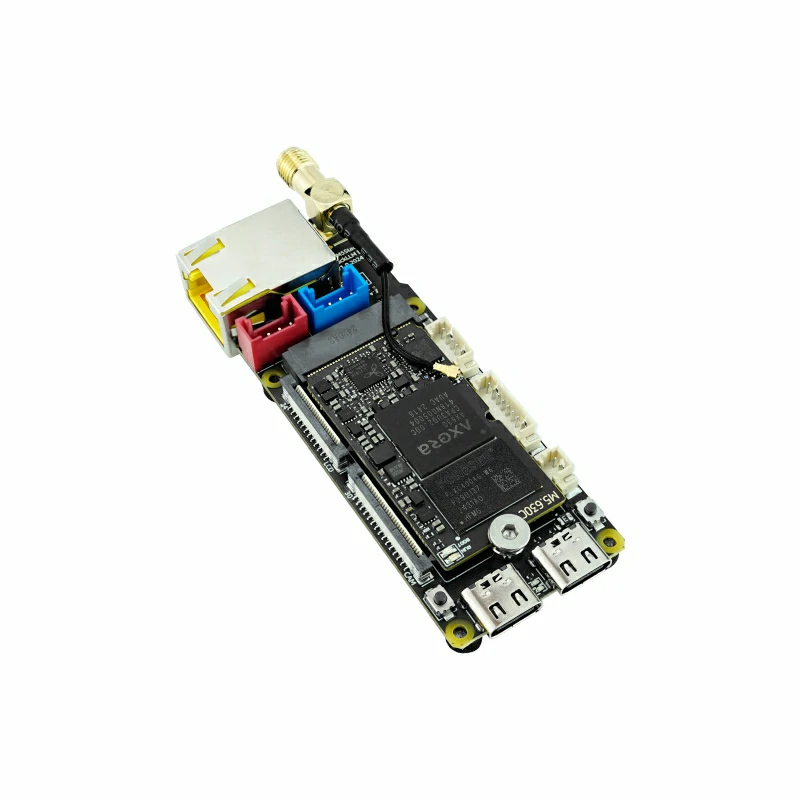
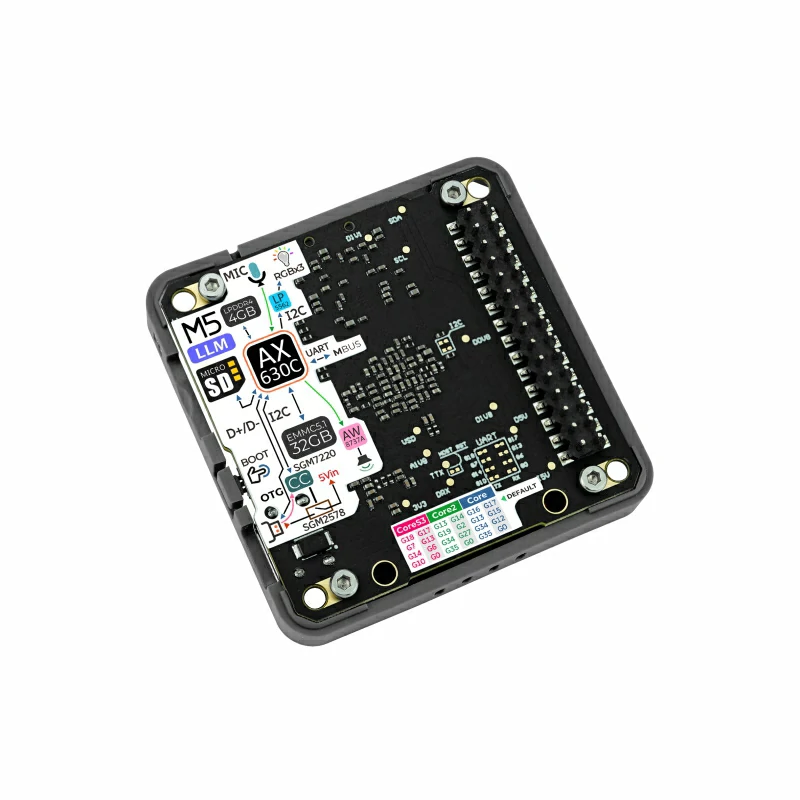
注意
软件包和模型包需要与设备平台匹配,请使用对应设备安装教程中的软件源和命令。
调用方式
StackFlow API
StackFlow API 使用 JSON 数据包配置和调用 LLM、VLM、语音及视觉等功能服务。JSON 数据可以通过 UART 或 TCP 传输,具体通信接口取决于所使用的设备。
| 设备 | 通信方式 | 使用场景 |
|---|---|---|
| Module LLM | UART,默认 115200bps 8N1 | 由 Core、Arduino 或其他主控直接发送 JSON 指令 |
| LLM630 Compute Kit | TCP,默认端口 10001 | PC 或同一网络中的设备通过 Socket 发送 JSON 指令 |
| AI Pyramid | TCP,默认端口 10001 | 设备本机应用或网络客户端通过 Socket 发送 JSON 指令 |
无论使用 UART 还是 TCP,调用过程都由 JSON 消息完成。例如,客户端通过 action 和 object 指定操作,通过 data 传入模型及运行参数:
{
  "request_id": "llm_001",
  "work_id": "llm",
  "action": "setup",
  "object": "llm.setup",
  "data": {
    "model": "qwen2.5-0.5B-prefill-20e"
  }
}完成初始化后,客户端可以继续发送推理数据,并通过返回的 work_id 识别对应的任务。相关文档:
OpenAI 兼容 API
安装 llm-openai-api 后,设备会在本地提供与 OpenAI API 格式兼容的 HTTP 接口。OpenAI SDK、Chatbox 等现有客户端通常只需将服务地址修改为设备的 IP 地址,即可调用设备上运行的模型。
这里的“OpenAI 兼容”指接口格式兼容,并不表示模型运行在 OpenAI 云端;推理请求由本地设备处理。
模型库
按模型能力查看安装要求、调用方式和支持的硬件平台。
开发示例
示例页面可能使用某款设备进行验证;能否在其他设备上运行,取决于该设备是否提供对应的功能服务与模型包。
Page Tools